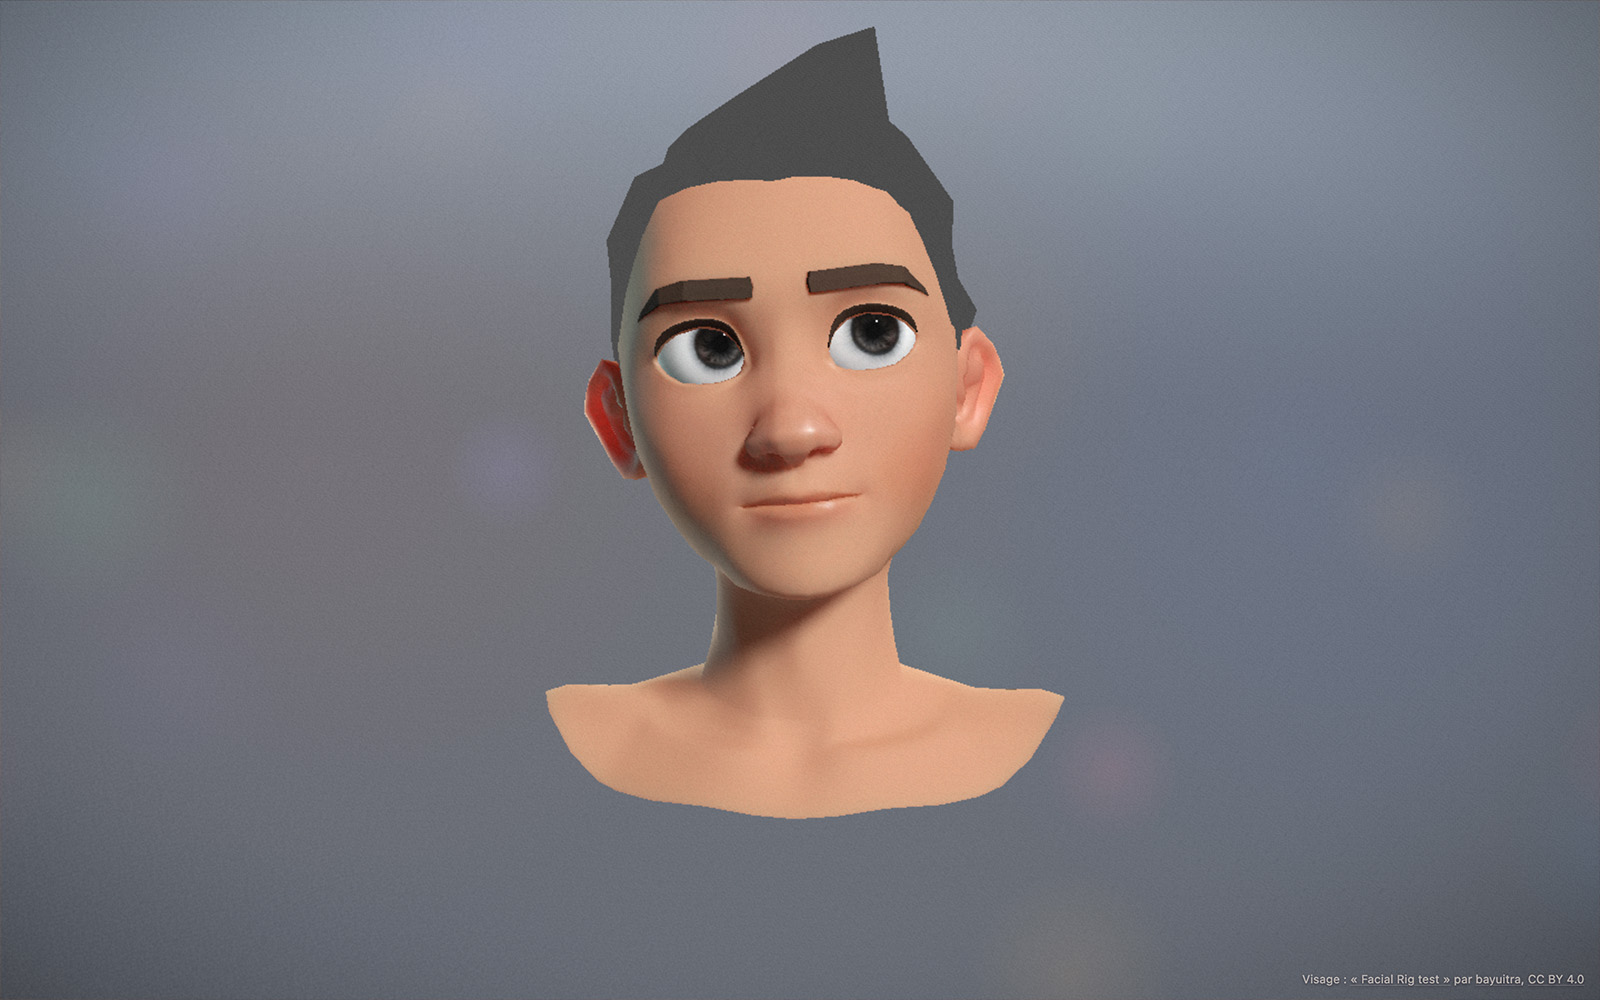
Donnez-lui un fichier audio ou parlez dans le micro : un visage 3D articule ce qu’il entend, syllabe par syllabe.
Vue d’ensemble
3D Speech reprend le studio photo de Midi 3D, mais sans clavier : c’est le son qui fait parler une tête 3D au style de film d’animation. On peut écouter la démo (« Butters n’est pas heureux »), importer son propre fichier, le glisser directement sur la page, ou parler dans le micro et le voir répéter en direct.
Dans Midi 3D, chaque mouvement de bouche était calculé à l’avance pour un échantillon précis. Ici l’audio est inconnu, donc tout se décide en temps réel : l’ouverture de la bouche suit les syllabes, sa forme suit la voyelle entendue (a, i, ou, é, o), et les lèvres se ferment sur les m, b et p. Entre deux phrases, il cligne des yeux, détourne le regard comme quelqu’un qui réfléchit, puis revient vers vous.
Fonctionnalités
- Votre propre audio : MP3, WAV, OGG, M4A… via le bouton Importer ou en glissant le fichier sur la page. Rien n’est envoyé sur un serveur, le fichier reste dans le navigateur.
- Micro en direct : parlez ou chantez, le visage articule en même temps que vous.
- Lecteur complet : lecture et pause, barre de progression cliquable, lecture en boucle activable.
- Un visage qui a de l’humeur : au fil du discours il change d’expression (posé, intrigué, rêveur, joueur, surpris…), hausse les sourcils ou plisse les yeux sur les accents, et un son fort et soutenu le fait froncer les sourcils.
- Un regard qui vous suit : ses yeux et sa tête suivent la caméra quand on tourne autour de lui, et il hoche la tête sur les syllabes accentuées.
- Décor qui écoute : le halo derrière la tête et le contre-jour s’intensifient quand la voix monte.
- Plein écran et mode épuré pour ne garder que le visage.
Sous le capot
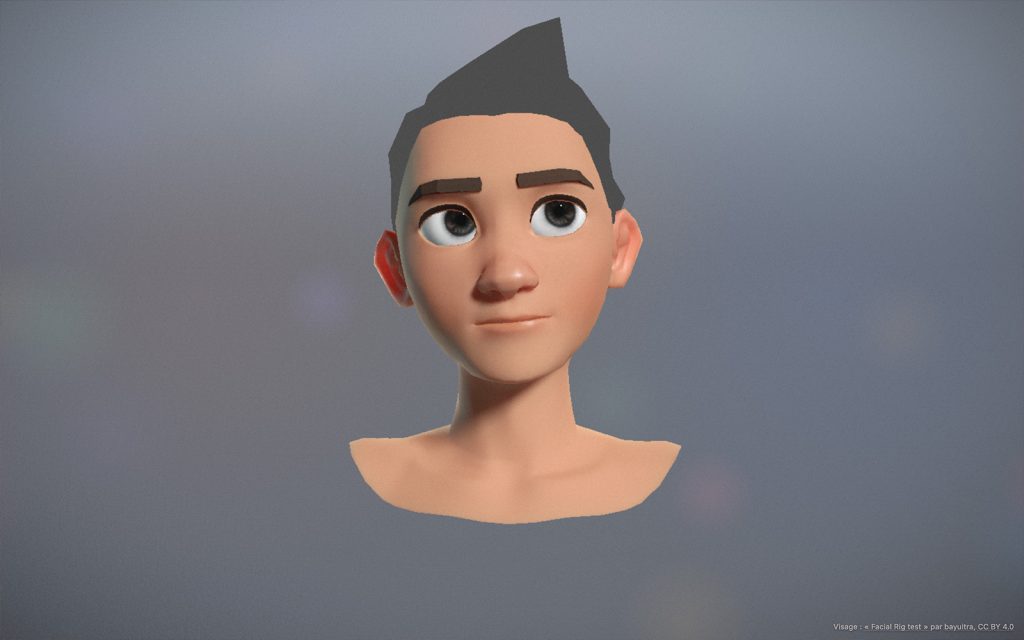
Le visage, « Facial Rig test » de bayuitra, n’a aucune forme de déformation prête à l’emploi : tout passe par un squelette facial d’environ 150 os (mâchoire, lèvres, paupières, sourcils, yeux, nez). three.js ne sait pas rejouer les contraintes de Blender qui relient ces os, mais le modèle contient une animation de démonstration où chaque os est enregistré. Au chargement, l’app fige cette animation sur quelques images bien choisies (yeux fermés, bouche ouverte, sourire, lèvres arrondies, moue, sourcils levés ou froncés) et n’en garde que la zone utile. Chaque pose devient un écart à la position de repos, que l’on dose ensuite avec un poids, comme un blendshape.
À chaque image, l’app mesure le volume du son puis l’énergie de deux bandes de fréquences, autour de 250 à 900 Hz et de 900 à 2600 Hz. Ce sont les zones des deux premiers formants de la voix : la première monte quand la bouche s’ouvre (a, o), la seconde quand la langue avance (i, é). Leur position désigne une voyelle, et les cinq formes de bouche se mélangent en douceur selon la plus proche. Une chute brusque du volume referme les lèvres, comme sur un p ; un souffle aigu les garde presque jointes, comme sur un f.
Pour que la bouche ait l’air de parler plutôt que de rester béante, l’ouverture ne suit pas le volume brut : on en retire une version lissée sur un tiers de seconde, ce qui fait ressortir chaque attaque de syllabe et referme la bouche entre deux. Comme on ne connaît pas la suite du son, les niveaux de référence (pic de volume, bruit de fond du micro, registre de la voix, position des formants) s’ajustent en continu au lieu d’être mesurés sur tout le fichier.
Le reste du jeu d’acteur est procédural. Les clignements tombent toutes les deux à six secondes, plus souvent dans le silence et parfois en double. Le regard fait de petites saccades et se détourne pendant les pauses. Les yeux sont tournés os par os vers la caméra, et la tête l’accompagne quand l’angle devient trop grand. Sur les syllabes accentuées, la tête hoche grâce à un petit ressort amorti. Au repos, il respire, ce qui évite qu’il se fige.
Contrôles
| Touche / geste | Action |
|---|---|
| Glisser un fichier sur la page | Le charge et le lit |
| Espace | Lecture / pause |
| L | Boucle activée ou non |
| M | Micro en direct |
| H | Masque l’interface |
| F / ⛶ | Plein écran |
| Glisser, pincer | Tourner autour du visage, zoomer |
Stack technique
- Vanilla JS en modules, aucun build
- Three.js : squelette facial piloté os par os, bloom et vignettage en post-traitement
- Web Audio : AnalyserNode pour le volume, le spectre et les formants, micro via getUserMedia
- Modèle « Facial Rig test » par bayuitra (Sketchfab), sous licence CC BY 4.0
Cas d’usage
Faire réciter un podcast, un message vocal ou un couplet de rap à un visage en 3D, tester comment il réagit à une chanson, ou simplement lui parler et s’amuser de le voir répéter. Ça marche aussi comme petite démonstration de lip-sync dans le navigateur, sans rien installer.
Il ne comprend pas un mot, mais il articule tout.